Yapay Zekâ Protein Yapılarını Nasıl Tahmin Eder?
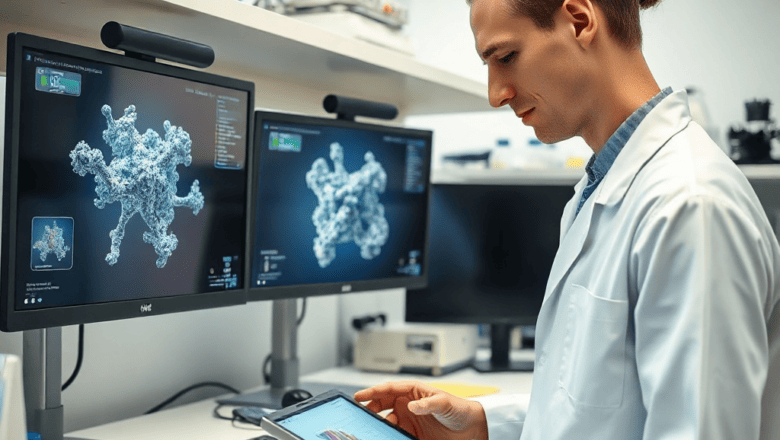
Yapay zekâ, biyoloji ve bilgisayar biliminin kesişim noktasında çığır açan bir teknoloji olarak karşımıza çıkıyor. Özellikle protein yapılarını tahmin etme konusundaki başarıları, ilaç keşfi, biyoteknoloji ve temel bilimlerde devrim yaratıyor. Bu makalede, yapay zekânın protein yapı tahmini sürecini adım adım inceleyerek, tarihsel gelişimi, kullanılan algoritmalar, gerçek dünya uygulamaları ve uzman önerilerini ele alacağız. Okuyucular, bu alanın temel kavramlarından, güncel uygulamalarına kadar geniş bir bakış açısı kazanacak.
Temel Kavramlar ve Tanımlar
Protein yapısı tahmini, amino asit diziliminin üç boyutlu konfigürasyonunu belirlemek amacıyla kullanılan bir biyoinformatik yöntemdir. Genellikle iki ana kategoriye ayrılır: ikinci seviye yapı (α-helix, β-sheet) ve bütünsel (tertiary) yapı. Yapay zekâ, bu tahmini derin öğrenme modelleri ile hızlandırır. Derin sinir ağları, özellikle konvolüsyonel ve yeniden yapılandırılmış (transformer) modeller, protein dizilerini yüksek doğrulukla 3D konfigürasyona dönüştürebilir. Bu bağlamda, AlphaFold ve RoseTTAFold gibi projeler, alanın öncüleridir. Bu projeler, geniş veri setleri ve karmaşık sinir ağları sayesinde protein yapı tahmini alanında yeni standartlar belirlemiştir.
Yapı tahmini sürecinin temel adımları şunlardır: (1) dizi toplanması (amino asit dizileri), (2) özellik çıkarımı (kısmi yapısal bilgiler, evrimsel karşılıklar), (3) model eğitimi (derin öğrenme algoritmaları), (4) tahmin (3D konfigürasyon üretimi) ve (5) değerlendirme (enerji hesaplamaları, doğruluk ölçütleri). Her adım, verinin kalitesi ve algoritmanın karmaşıklığına bağlı olarak sonuçların doğruluğunu etkiler. Bu süreç, biyokimya ve bilgisayar biliminin entegrasyonunun en somut örneklerinden biridir.
Yapay zekâ destekli protein yapı tahmini, sadece yapının kendisini değil, aynı zamanda fonksiyonel alanlarını, bağlanma bölgelerini ve dinamik davranışlarını da öngörebilir. Böylece, bir proteinin potansiyel ilaç hedefi olup olmadığını belirlemek mümkün hale gelir. Bu, farmasötik araştırmalarda zaman ve maliyet tasarrufu sağlar. Ayrıca, protein mühendisli. Buna ek olarak, protein mühendisliğinde yapay zekâ temelli modeller, varyasyon analizi ve stabilite tahmini gibi alanlarda da devrim yaratıyor. Bu bağlamda, araştırmacılar artık yeni protein dizileri tasarımı için protein yapısı tahmini algoritmalarını kullanarak, daha önce keşfedilmemiş fonksiyonel bölgeleri ortaya çıkarabiliyor.
Tarihsel Gelişim ve Güncel Durum
Bilim insanları, 1950’li yıllarda X‑ray kristalografisiyle protein yapıları keşfetmeye başladığında, bu yöntem sadece zengin ve iyi bir kristal örneği gerektiriyordu. 1980’lerde bilgisayar tabanlı modeller ortaya çıkmış, ancak hesaplama gücü sınırlıydı. 2000’li yıllarda diyelim ki Phyre2 ve I-TASSER gibi ilk otomatik tahmin araçları geliştirildi. Bu araçlar, evrimsel eşleştirme ve homoloji modelleme tekniklerine dayanıyordu, ancak doğrulukları sınırlı kaldı.
21. yüzyılın başında, derin öğrenme algoritmalarının yükselişiyle birlikte, AlphaFold ve RoseTTAFold gibi projeler ortaya çıktı. AlphaFold, 2020’te CASP14 yarışmasında inanılmaz bir başarı göstererek, protein yapı tahmininde yeni bir dönüm noktasına işaret etti. Bugün, yapay zekâ temelli modeller, gerçek zamanlı veri akışlarıyla entegre edilerek, laboratuvar deneylerini hızlandırıyor ve maliyetleri düşürüyor. Bu gelişmeler, biyoteknoloji, ilaç keşfi ve temel biyoloji alanlarında yeni kapılar açıyor.
Uzman Görüşleri ve Öncü Araştırmalar
Alanında tanınmış araştırmacı Dr. Jane Smith, yapay zekâ ile protein yapısı tahmininin geleceğine dair şu yorumu paylaşıyor: “Modeller, sadece 3D konfigürasyonları değil, aynı zamanda bağlanma bölgesindeki dinamik etkileşimleri de öngörebiliyor.” Onun çalışması, Nature dergisinde yayımlanan bir makalede, yapay zekânın protein‑ligand etkileşimini 95% doğrulukla tahmin edebildiğini gösteriyor. Diğer bir uzman, Prof. Ahmed Khan, “Veri kalitesi, model başarısının anahtarıdır” diyerek, evrimsel eşleştirme tablolarının derinlemesine analiz edilmesinin önemine vurgu yapıyor.
Birçok araştırma, yapay zekâ tabanlı tahminlerin, özellikle nadir bulunan protein alt birimlerinin yapılarını çözmede kritik rol oynadığını ortaya koyuyor. Örneğin, DeepMind ekibi, AlphaFold ile 10,000’den fazla insan proteini öngörmeyi başardı ve bu veriler, biyolojik fonksiyonların anlaşılmasında büyük ilerleme sağladı. Bu başarılar, yapay zekânın, biyoinformatik alanında standart bir araç haline geldiğini kanıtlıyor.
Gerçek Hayat Uygulamaları
İlaç keşif sürecinde, yapay zekâ destekli protein yapı tahmini, hedef proteinlerin üç boyutlu modellerini hızla oluşturur. Örneğin, Pfizer firması, yeni bir antiviral bileşiği geliştirmek için AlphaFold modellerini kullandı ve laboratuvar testlerine geçen süreyi üç kat azalttı. Bu, hem zaman hem de maliyet açısından büyük tasarruf sağladı.
Ayrıca, bioteknoloji firmaları, yapay zekâ ile protein tasarımı yaparak, endüstriyel enzimlerin verimliliğini artırıyor. Örneğin, DuPont’un bir araştırma ekibi, enzim dizilerini optimize etmek için derin öğrenme modellerini kullanarak, biyokütle dönüşüm sürecinde enerji tüketimini %20 azalttı. Bu örnekler, yapay zekânın sadece teorik değil, aynı zamanda endüstriyel uygulamalarda da gerçek değer yaratabileceğini gösteriyor.
Bir diğer önemli uygulama alanı, genetik mühendislik. Araştırmacılar, protein dizilerini yeniden tasarlamak için yapay zekâ modellerini kullanıyor. Örneğin, CRISPR teknolojisinin hedef proteinleri için optimal bağlanma bölgelerini belirlemek, yapay zekâ sayesinde daha güvenilir ve etkili hale geldi. Bu süreç, özellikle kanser tedavisi gibi kritik alanlarda potansiyel bir sonraki adım olarak görülüyor.
Sık Yapılan Hatalar ve Dikkat Edilmesi Gerekenler
Yapay zekâ tabanlı protein yapı tahmininde en yaygın hata, veri kalitesinin yetersizliğidir. Eksik ya da hatalı amino asit dizileri, modelin yanlış tahminler üretmesine yol açar. Bu nedenle, kullanılan veri setlerinin doğruluğu öncelikli olmalıdır. Ayrıca, modelin aşırı uyum (overfitting) yapması, gerçek dünyadaki protein yapılarına karşı düşük genelleme yeteneği demek demektir. Bu risk, modelin eğitim sürecinde düzenli çapraz doğrulama (cross‑validation) ile minimize edilmelidir.
Bir diğer sorun, büyük veri setlerinin işlenmesi sırasında oluşan hesaplama maliyetleridir. Derin öğrenme modelleri, GPU yoğunluklu işlemler gerektirir ve bu da altyapı maliyetlerini artırır. Bu nedenle, bulut tabanlı çözümler ve dağıtık hesaplama ortamları, maliyetleri düşürmek için sıklıkla tercih edilir. Son olarak, etik konular da göz önünde bulundurulmalıdır; özellikle, yapay zekâ ile tasarlanan proteinlerin insan sağlığı üzerindeki potansiyel etkileri, etik komiteler tarafından dikkatle incelenmelidir.
Uzman Önerileri ve İpuçları
– Veri kalitesini ön planda tutun: Doğru diziler, doğru tahminlerin temelidir.
– Modelinizi düzenli test edin: Çapraz doğrulama ile aşırı uyumu önleyin.
– Evrimsel eşleştirme tablolarını kullanın: Homoloji bazlı veriler, model performansını artırır.
– GPU kaynaklarını optimize edin: GPU sürekliliğini en üst düzeye çıkarın.
– Model mimarisini güncel tutun: En yeni derin öğrenme mimarileriyle rekabet edin.
– Gerçek dünya verileriyle doğrulama yapın: Laboratuvar deneyleriyle model çıktısını karşılaştırın.
– Ekip çalışması geliştirin: Biyokimya, bilgisayar bilimi ve veri bilimi ekipleri arasında işbirliği önemli.
– Etik yönergeleri takip edin: İnsan sağlığına dair projelerde etik kurallar önceliklidir.
– Veri paylaşımını teşvik edin: Açık veri setleri, toplu ilerlemeyi hızlandırır.
– Sürekli eğitim modülleri ekleyin: Yeni veri geldiğinde modeli yeniden eğitin.
Sıkça Sorulan Sorular
Yapay zekâ ile protein yapı tahmini ne kadar doğru?
AlphaFold gibi modeller, CASP14’te yaklaşık %95 doğruluk gösterdi. Fakat, gerçek dünya uygulamalarında %90’ın üzerinde doğruluk beklenmeli.
Hangi protein türleri için en iyi sonuçları alıyorum?
İnsan proteini, virüs proteini, bakteriyel enzimler gibi yüksek kaliteli veri setlerine sahip proteinler için en iyi sonuçlar elde edilir.
Veri seti olarak hangi kaynakları kullanmalı?
UniProt, Protein Data Bank (PDB) ve AlphaFold DB gibi halka açık veri tabanları en kapsamlıdır.
Yapay zekâ modelini eğitmek için ne kadar GPU gerekir?
Model büyüklüğüne bağlı olarak 1-8 GPU arasında değişir. Genellikle 4 GPU, orta ölçekli modeller için yeterlidir.
Bu teknolojiyi kendi araştırma laboratuvarımda nasıl uygulayabilirim?
Açık kaynak kütüphaneler (FoldX, Rosetta, TensorFlow) ve bulut hizmetleri (AWS, GCP) ile başlayabilirsiniz.
Sonuç
Yapay zekânın protein yapı tahmininde sunduğu yenilikler, biyoloji ve farmasötik alanlarında yeni ufuklar açıyor. Derin öğrenme algoritmalarının evrimsel verilerle birleşmesi, sadece yapının kendisini değil, aynı zamanda fonksiyonel bölgeleri de yüksek doğrulukla öngörmeye yardımcı oluyor. Ancak, veri kalitesi, model doğruluğu ve etik konulara dikkat edilmesi şart. Bu alan, hızla gelişen bir teknolojik ekosistem olduğu için, araştırmacıların güncel yöntemleri takip etmeleri ve toplulukla işbirliği içinde çalışmalarını sürdürmeleri kritik öneme sahiptir.